图层分解:1. 从 qwen-image-layered 开始
一、背景
图像编辑的核心难题在于一致性:修改局部内容时,如何避免语义漂移(例如人物身份改变)和几何错位(位置/尺度偏移)。传统光栅图像(raster image)的所有视觉内容都融合在单一画布上,任何编辑都容易通过像素空间传播,导致不一致。
专业设计软件(如 Photoshop)采用分层(layered)表示,将图像分解为多个独立可编辑的RGBA 图层,编辑仅作用于目标图层,其他内容物理隔离,从而天然保证一致性。受分层思想的启发,图层分解(Layer Decomposition) 的将单张 RGB 图像自动分解为多个语义解耦的 RGBA 图层(每层含 RGB 颜色 + Alpha 透明度通道),实现固有可编辑性(inherent editability):每层可独立 recolor、replace、resize、reposition、remove 等操作,而不影响其他内容。
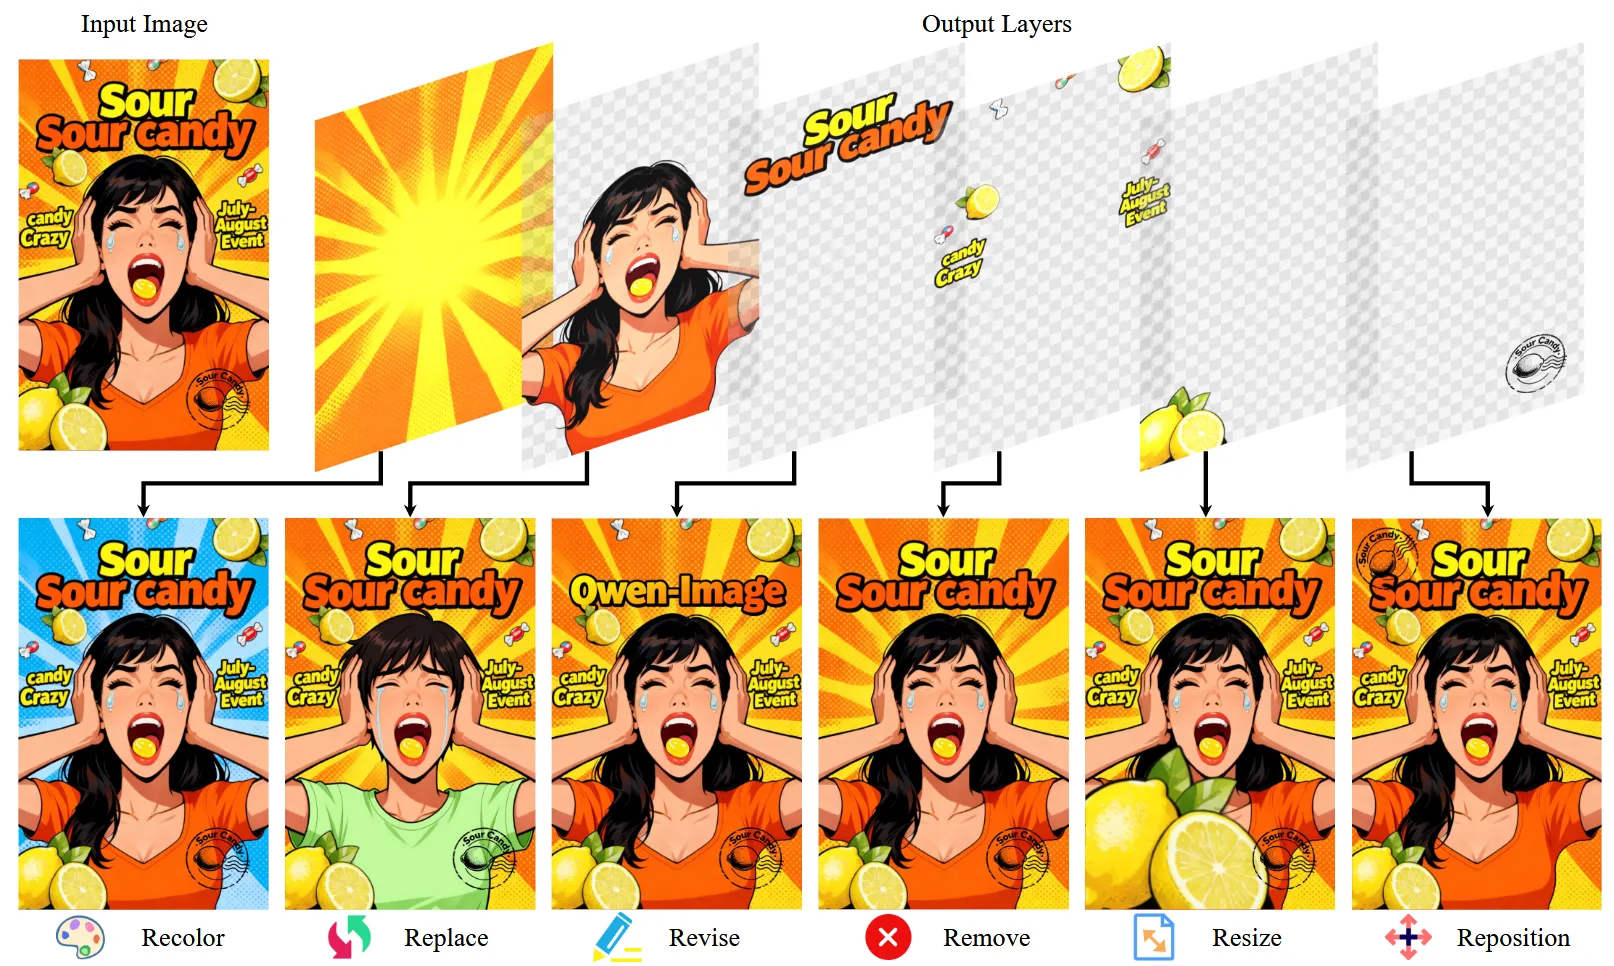 图源:Qwen-Image-Layered paper。
二、发展
2.1 Text2Layer
早期侧重从文本直接生成多层图像:
- Text2Layer(2023):先训练两层 Autoencoder,再扩散生成。
- LayerDiffusion:引入 latent transparency + LoRA。
- LayerDiff(ECCV 2024):LayerDiffusion 的基础上,通过设计层间和层内注意力,提出一种 traning-free 的方法。
- ART(CVPR 2025):匿名区域布局(不含语义的 bbox)实现可控可变层透明图像生成。
- PrismLayers(2025):开源了半合成的图层数据集:PrismLayers (PrismLayersPro) 200K (20K)。
2.2 Image2Layer
主要分为两种方法:
- 迭代提取:如 LayerD(ICCV 2025)、OmniPSD (2025),先用 SAM 等分割前景,再 inpainting 背景;或结合 VLM 引导(如 Accordion)。这些方法常需递归推理,易累积误差;
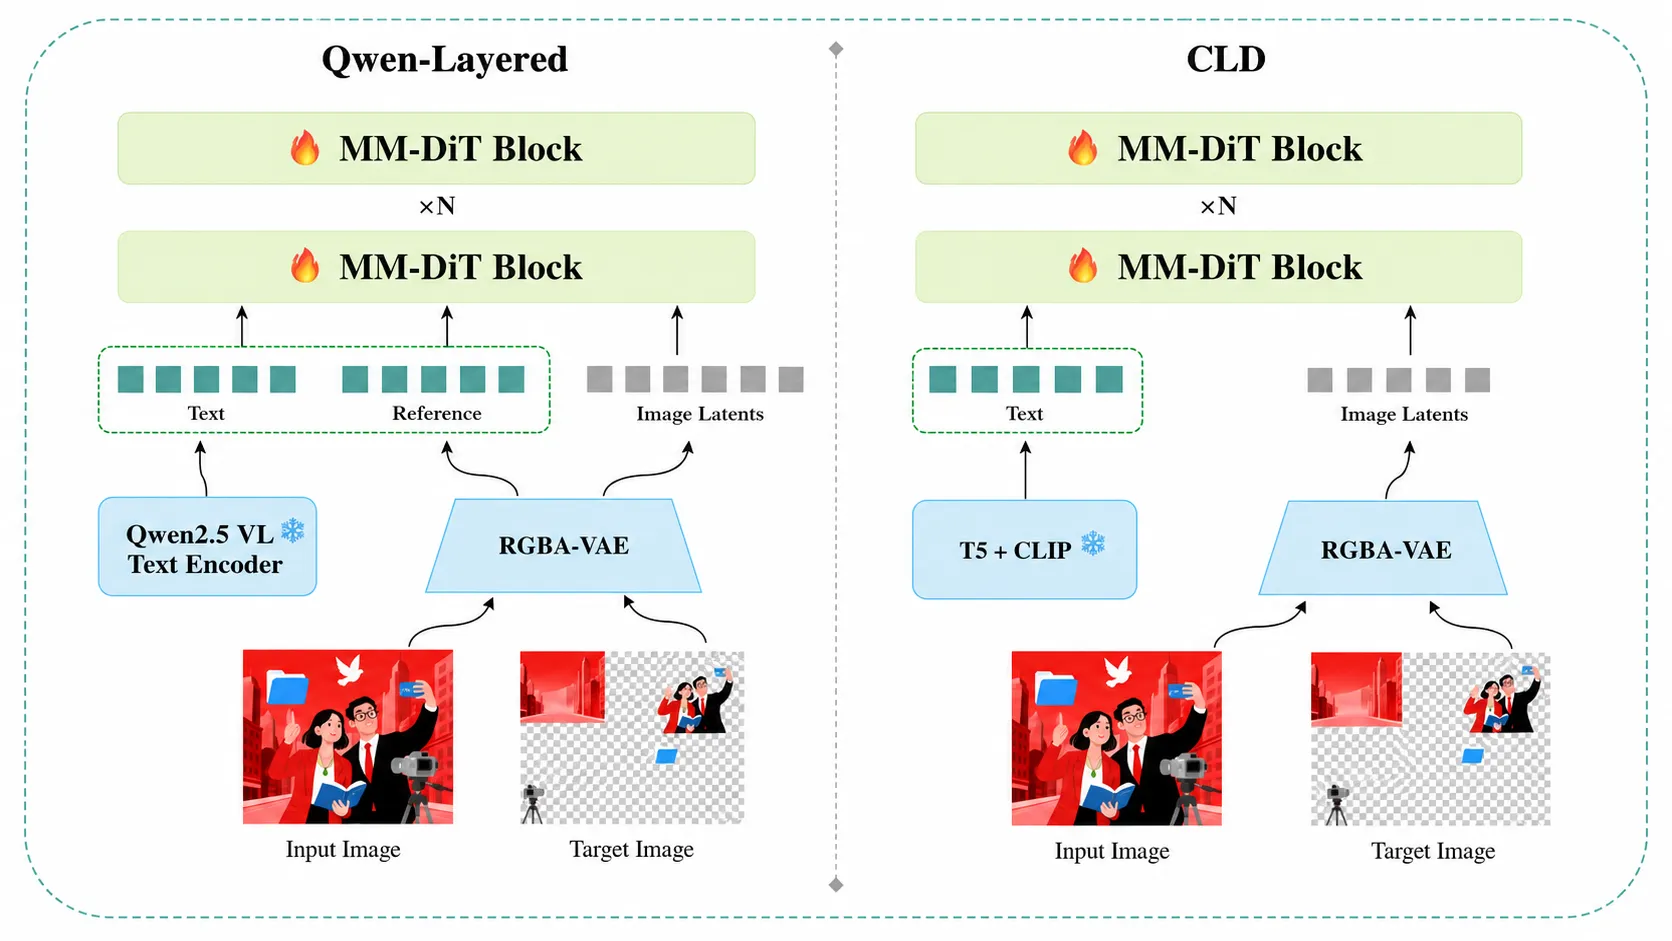
- 端到端生成:如 Qwen-Image-Layered、CLD,以 MM-DiT 为基础,在一次推理中同时生成对应的 RGBA 图层数据。
三、从 Qwen-Image-Layered 出发,问题与思考
3.1 Qwen-Image-Layered 的方法
3.1.1 RGBA-VAE
使用 Alpha-VAE 的思路,只扩展 encoder 第一层卷积层和 decoder 最后一层卷积层为四通道,初始化时复制预训练 RGB VAE 参数,结合重建、感知与正则损失训练。
3.1.2 VLD-MMDiT(Variable Layers Decomposition MMDiT)
支持可变层数。在每个 block 中,将条件图像 \(z_I\)、噪声状态 \(x_t\) 与文本条件拼接,通过 Multi-Modal Attention 同时建模层内与层间交互。引入 Layer3D RoPE(在 MSRoPE 基础上增加层维度),条件图像赋 layer index = -1,目标层从 0 开始,支持多任务(T2L / I2L)。
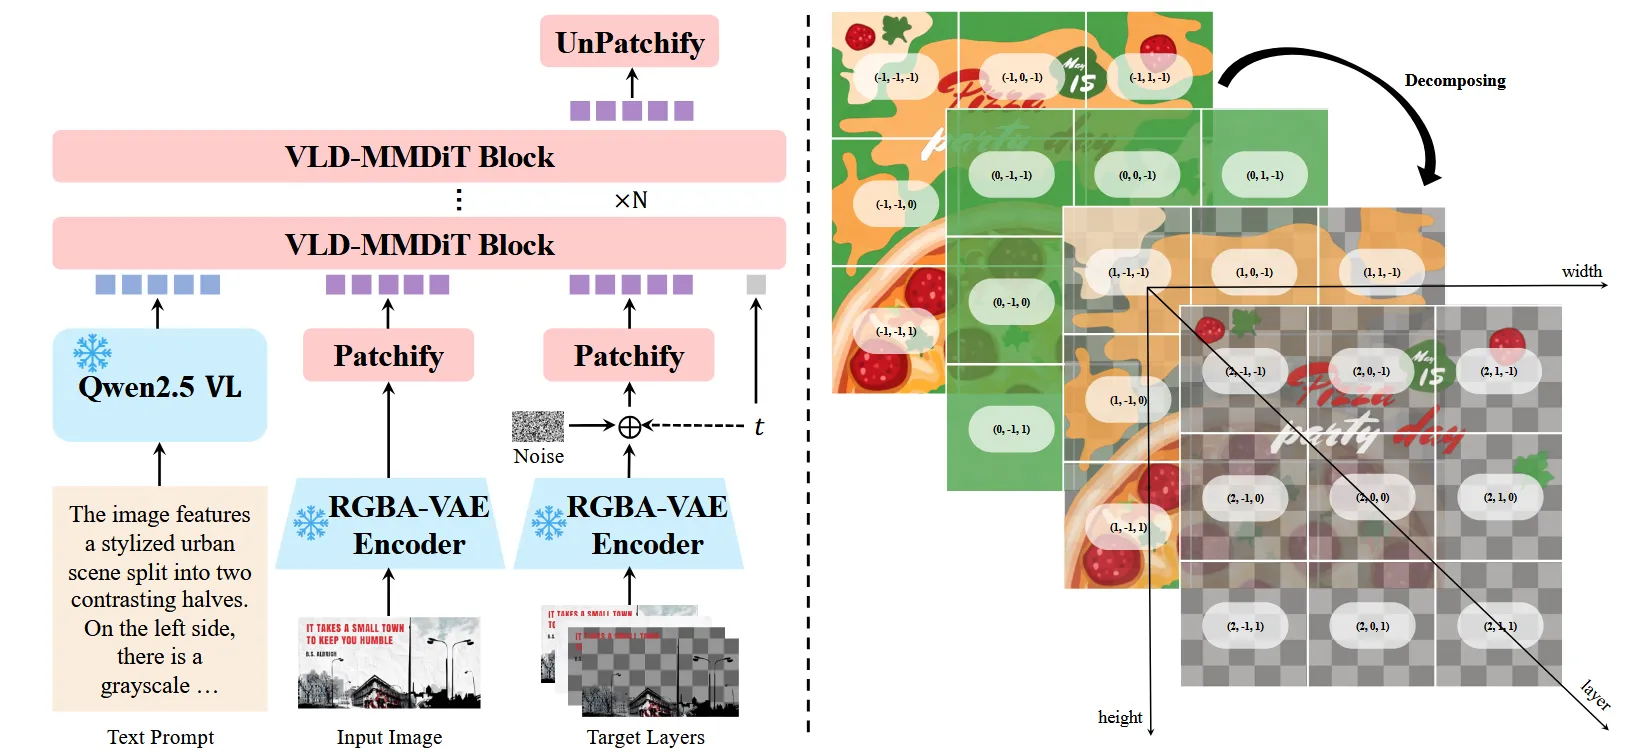
3.1.3 训练
采用三阶段训练:
- Stage 1: Text-to-RGB → Text-to-RGBA(适配新 VAE)
- Stage 2: Text-to-Multi-RGBA(引入层维度,支持复合图与透明层联合预测)
- Stage 3: Image-to-Multi-RGBA(I2L,加入图像条件)
在第二阶段 t2l 训练中,采用了 ART 的方法:将原始图片当成辅助的生成目标。并且在 i2l 中也保留了这个思想。
3.2 问题与思考
目前 Qwen-Image-Layered 仍然需要在推理的时候手动输入一个层数 \(N\):
def infer(input_image,
          seed=777,
          randomize_seed=False,
          prompt=None,
          neg_prompt=" ",
          true_guidance_scale=4.0,
          num_inference_steps=50,
          layer=4,
          cfg_norm=True,
          use_en_prompt=True):
如何在不预知 \(N\) 的情况下输出合理语义分组?这个问题进一步可以分为两个问题:
- 什么是合理的图层?评估是什么、怎么评估?
- 用什么方式去更好的得到图层 、模型如何决定?
3.2.1 合理图层的问题
先来看看第一个问题。同一张图中可以出现多种合理分层方式:
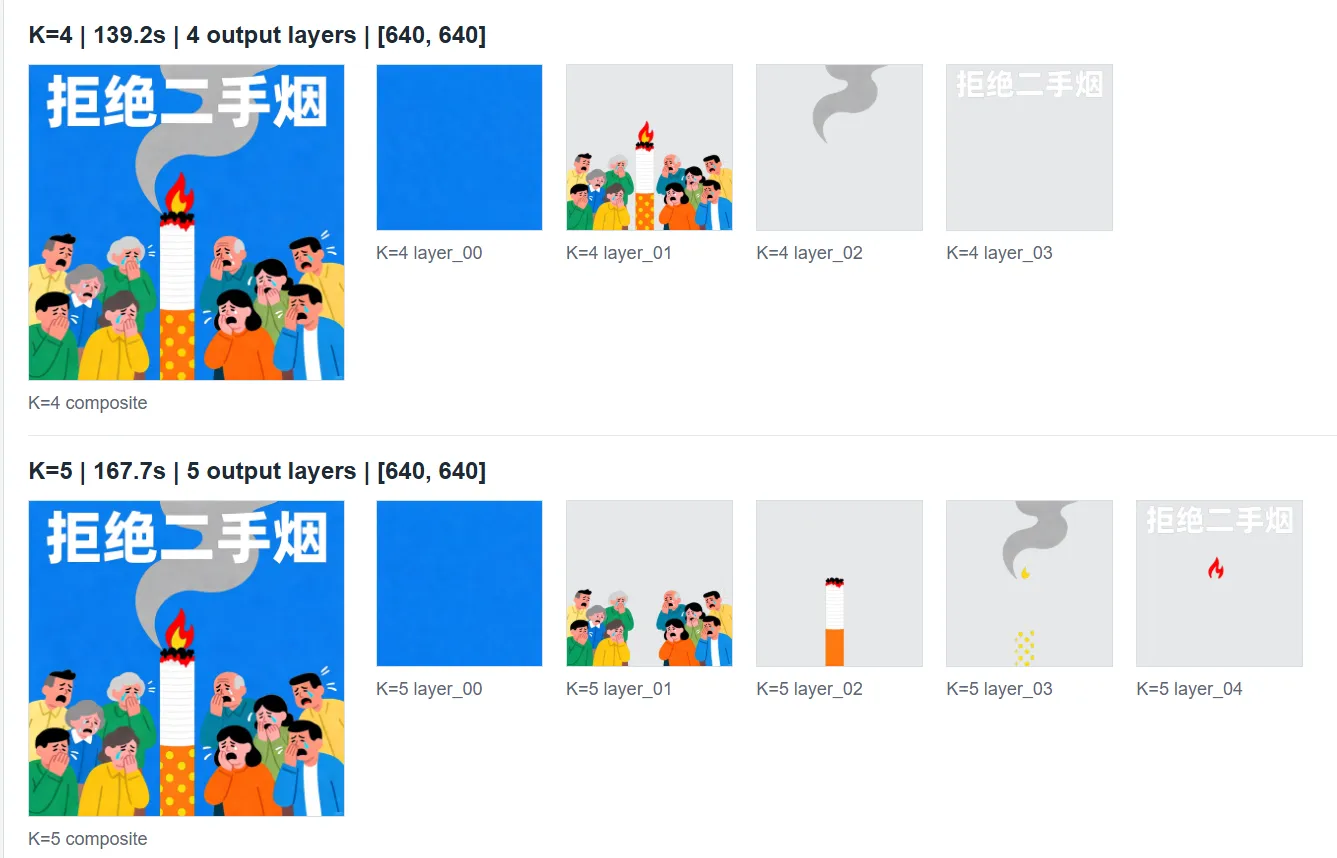
目前几乎所有的研究都没有关注这个问题,ground-truth 一般设定为真实 PSD 文件的层数。在图像评估方面,人本身就具备很强的主观性。很多种分层方式都可以当成合理的结果。可以考虑的因素太多太多。随意举例,如分层标准:可被编辑接受的最小层数 \(n_1\)、分成最多层 \(n_2\)(所有单个前景都应该作为单个图层)等。如果以分成最多层为标准,那么层数从 \(n_1\) 到 \(n_2\) 的结果就可以被视为不合理的分解方式:因为没有遵守标准。但实际上,这样的分层结果视觉上是可以被接受的。
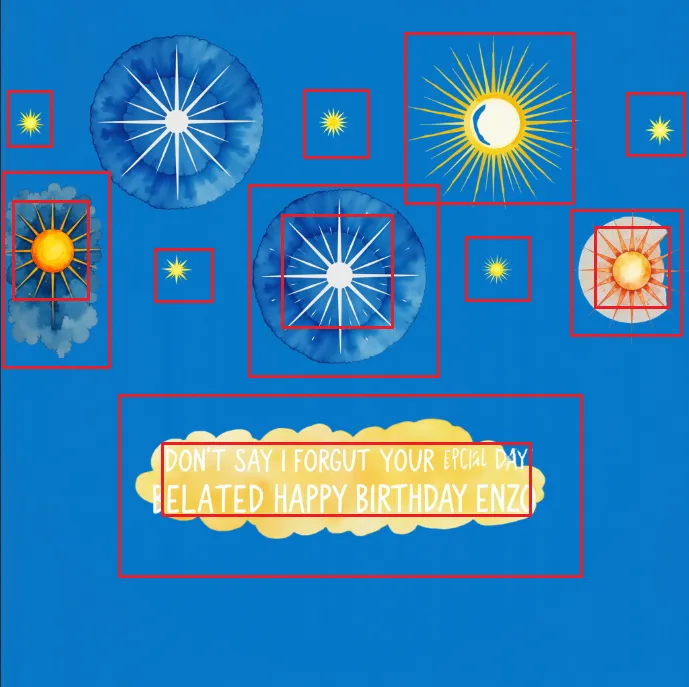
如下面这张图分成最多层:
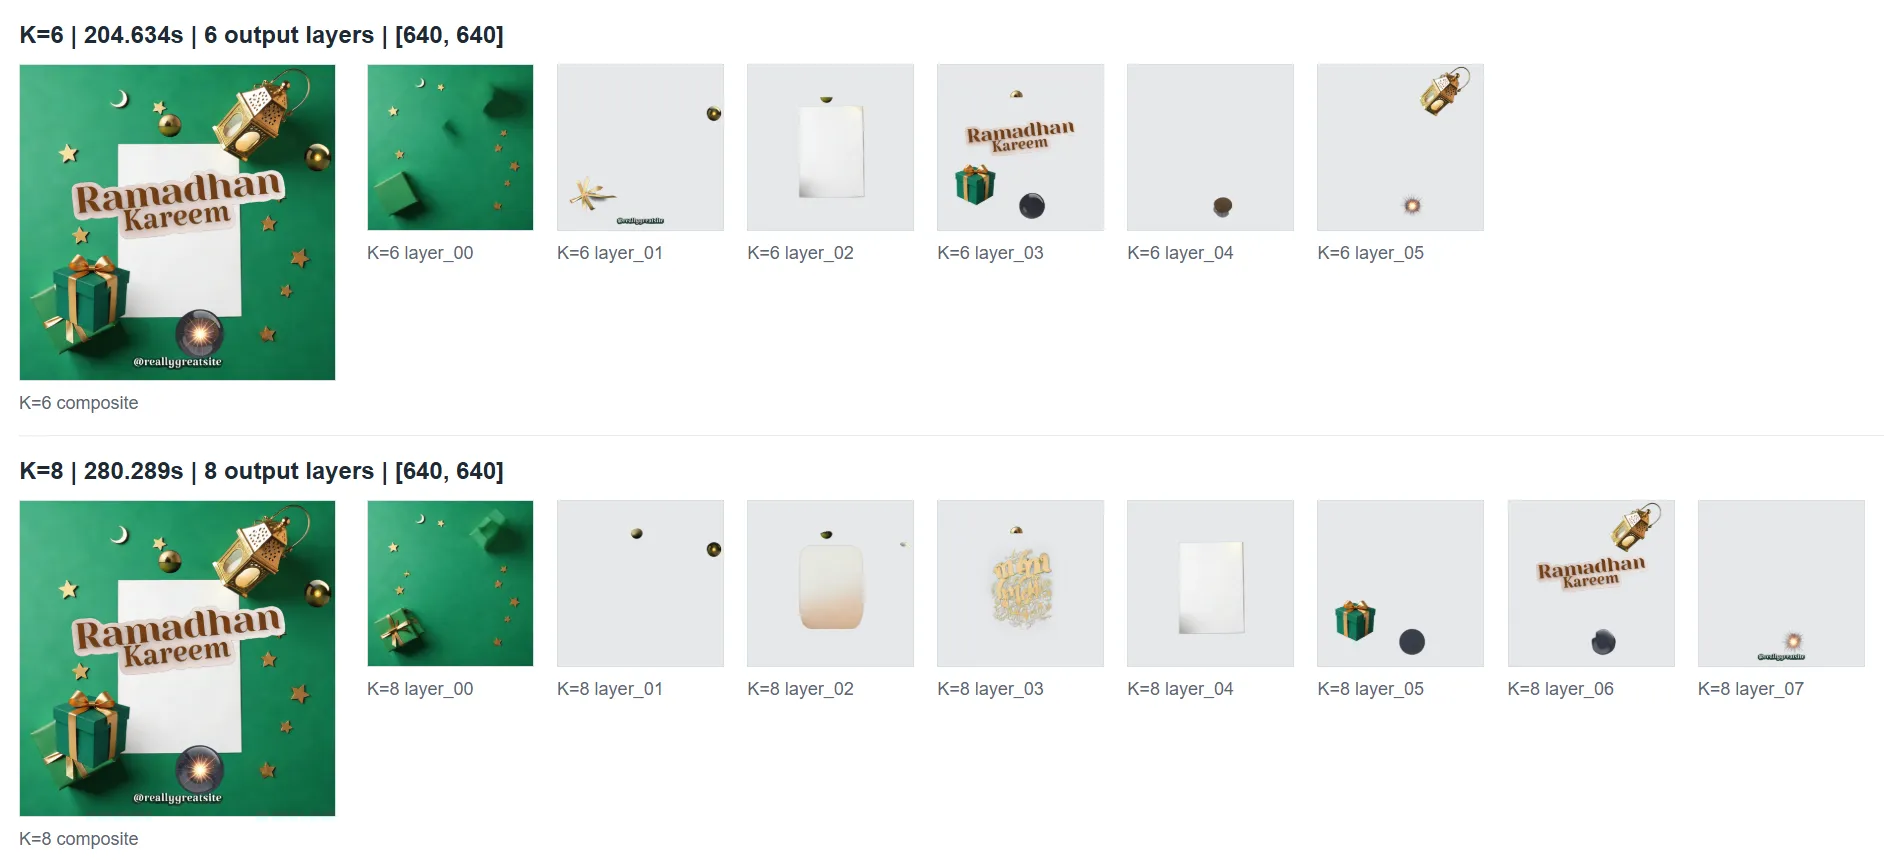
还有一个问题是,目前 qwen-image-layered 之类的方法倾向于最小的层数,因为如果你指定少了,模型顶多只会倾向不分图层。但如果指定过高的图层,模型会产生虚影和空层。不分图层当然也不好,但视觉上比虚影、空层等明显不合理的分层好接受。惩罚的权重应当不一样。还有考虑速度的问题:将图层的 latent token concat 起来联合去噪,高层数是几乎不能接受的,目前 qwen 这个模型在指定图层 \(k = 8\) 时推理大约是五分钟。
重要的是,上面的所有假设都是基于目前的模型可以完全做好图层分解这个任务这个前提,但实际上远远不够。以 qwen 为例子,在指定的 \(N\) 偏离 GT 过多时,模型很容易产生残影或者空层:
一种理想的方式是,将所有图层的分解方法一次性输出,形式非常漂亮,如:
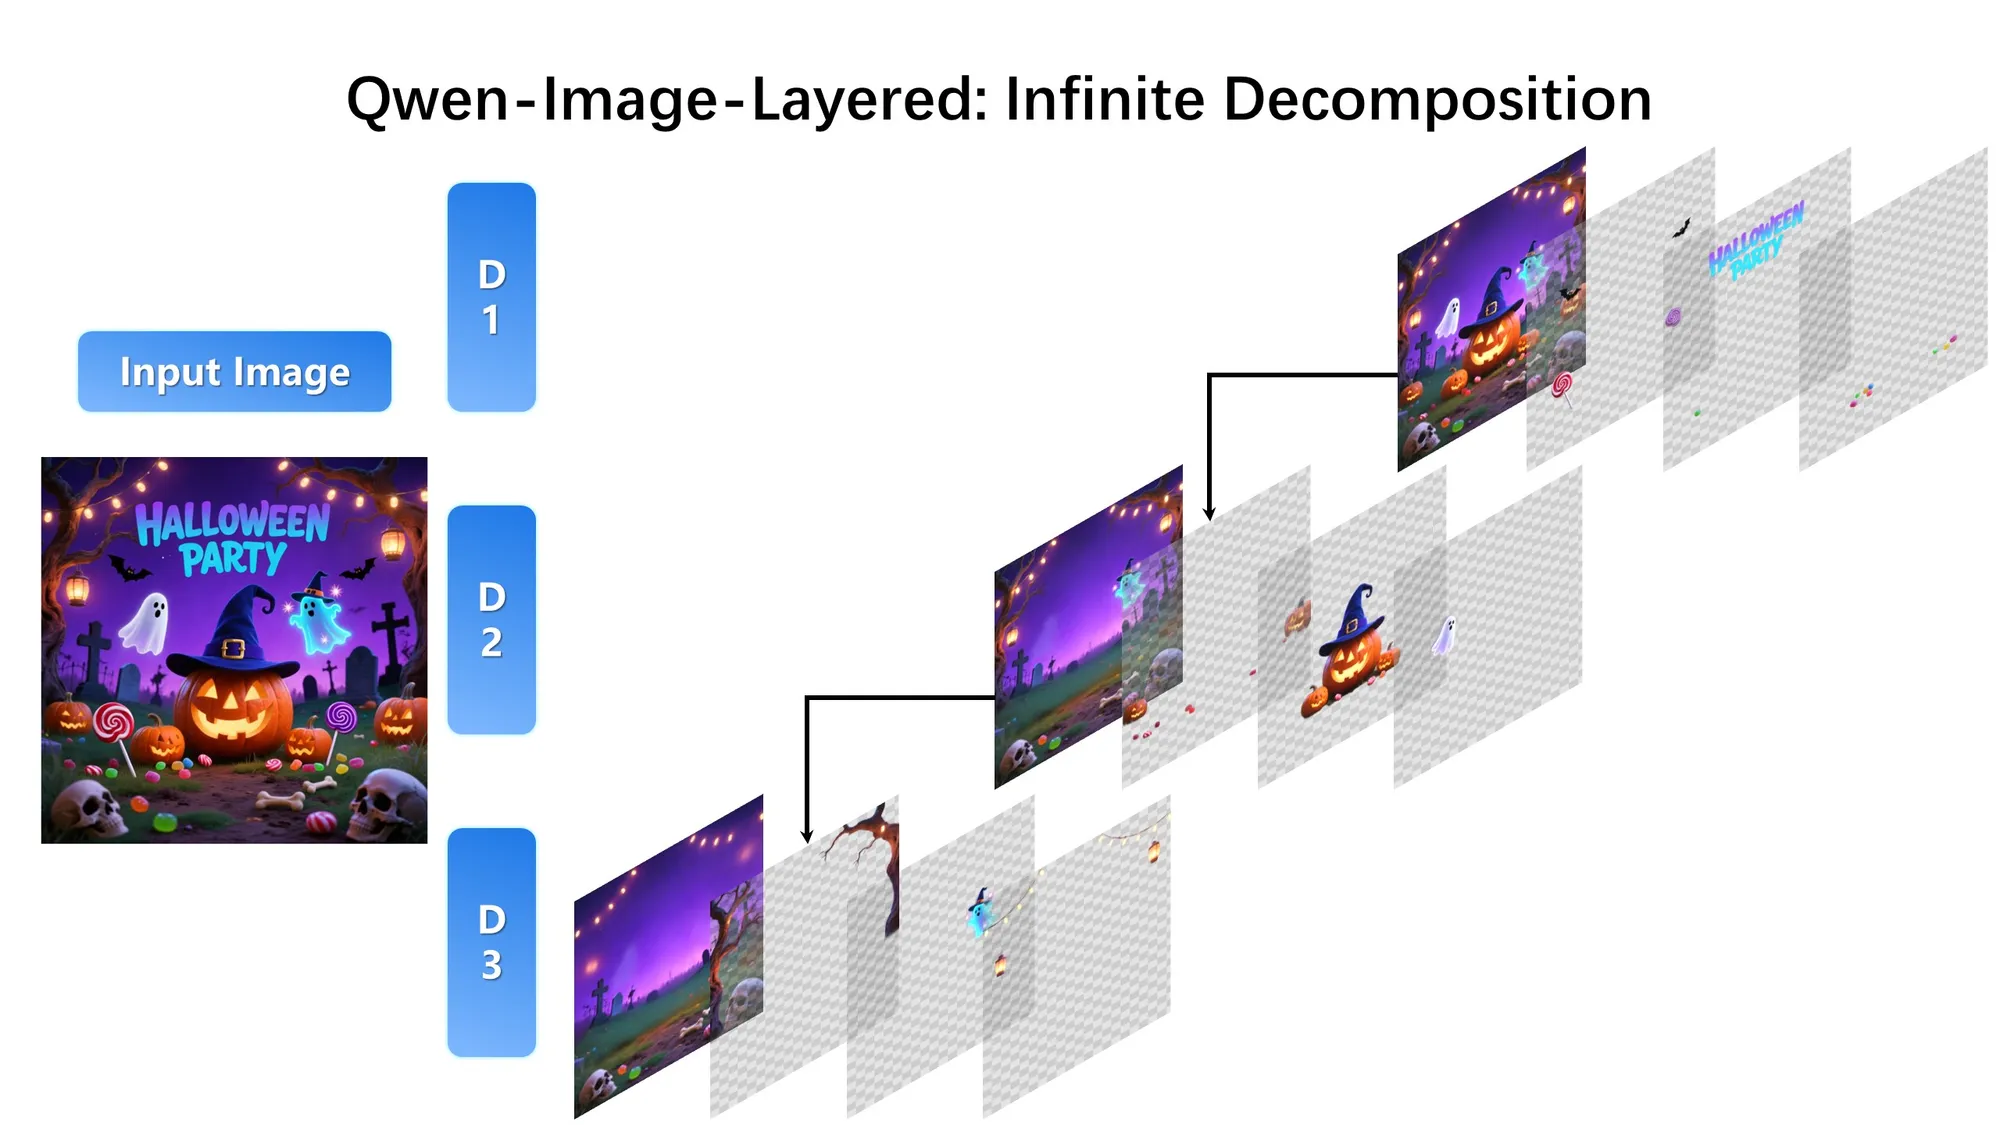 图源网络。
LayerD 类的迭代方法可能更适合。或者是从用户接入的角度思考、面向编辑的分层等。我其实感觉编辑是最终的任务。当然图层分解这个底层任务有它的作用,比如用户可能需要单独的一个元素作为素材。
3.2.2 如何分层
前面说到目前的模型还做不好分层。我其实一直很逃避,总会想现在是不是堆数据 scale up 上去就足够解决了?自然,即使可以 scale up 上去,方式也是不同的。
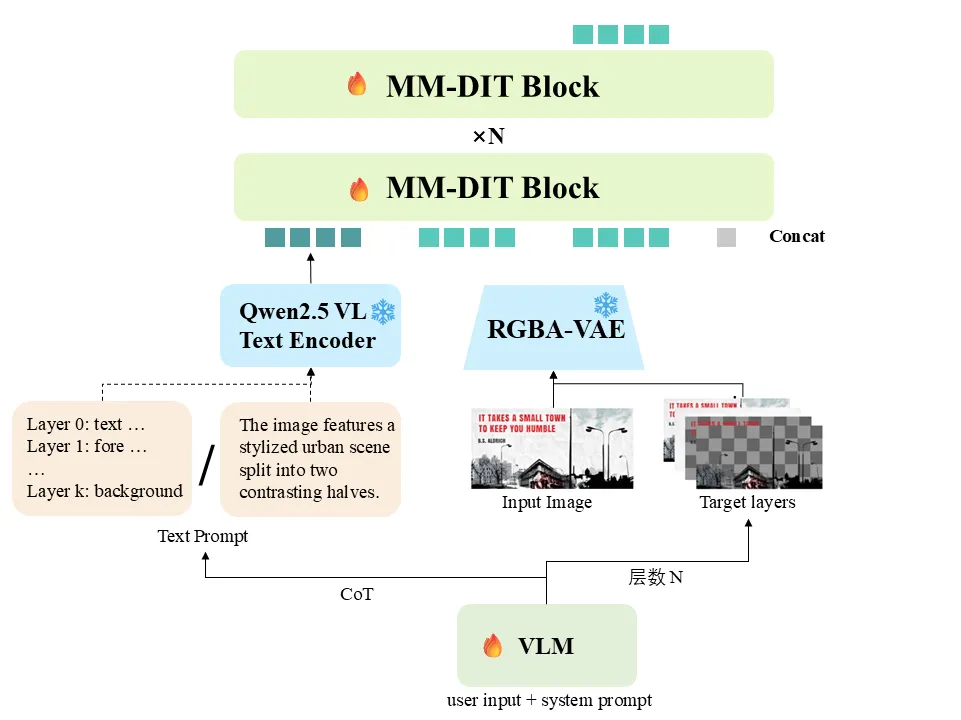
这是目前的架构:
3.2.3 图层分解任务中文本条件的作用
qwen 对 text prompt 不敏感,改变几乎无作用。单纯的图层分解任务和传统的文生图不同,输入图像是主要的信息来源,文本只是普通的描述,相当于被边缘化了。最新的论文也很少探讨这个问题,如 [2605.11818v1] RevealLayer: Disentangling Hidden and Visible Layers via Occlusion-Aware Image Decomposition,将文本条件固定为“Decompose the image into foreground and background”。
图像到图层并不是唯一确定的逆问题;样本相关、图层相关的语义条件可以消除分层粒度、对象归属和遮挡补全上的歧义。现有方法虽然保留文本接口